Wingman 怎麼做的?用 Jev 判斷、LLM 寫字,做一個回訊息小幫手
讓 Jev 先決定怎麼回,再請 LLM 寫成三則草稿,填進輸入框但不送出
每天在 Slack、LINE、Discord 之間切來切去,應該都有過這種經驗:訊息一則一則跳出來,有的要立刻回,有的只要回一個「收到」,光是判斷「這則到底要不要回、該怎麼回」,就已經花掉不少力氣。
九月底我做了一個叫 Wingman 的 macOS 選單列小工具,想幫自己省下這一步。有人傳訊息來,它會在輸入框上方浮出「✦ 3 則建議」,按 ⌥Space 展開三則草稿,最適合的那則標上 ★。按 Enter,它把那一則打進輸入框就停手,真正送出的 Enter 永遠由我自己按。
這篇文章想跟大家分享 Wingman 是怎麼做出來的:Jev 跟 LLM 各自負責什麼、七個聊天 App 怎麼讀、寫草稿的模型怎麼挑,以及公司的對話會經過誰的主機。
先說這個專案的核心想法,只有一句話:Jev 負責判斷,LLM 只負責寫字。
Jev 是 TypeSafe 的 System One 決策模型,它不會寫句子,只回答「選項固定的問題」,而且每個答案都附一個機率,例如這則訊息想要什麼、需不需要回、多急。一次判斷約 0.3 秒。LLM 拿到這些判斷之後才開始寫,所以一次建議等 2 到 4 秒,費用約 0.0002 美元。
目前支援 Slack、Discord、Messenger、Instagram、Threads、LINE、Telegram,原始碼在 GitHub,MIT 授權。
一次建議是怎麼跑的#
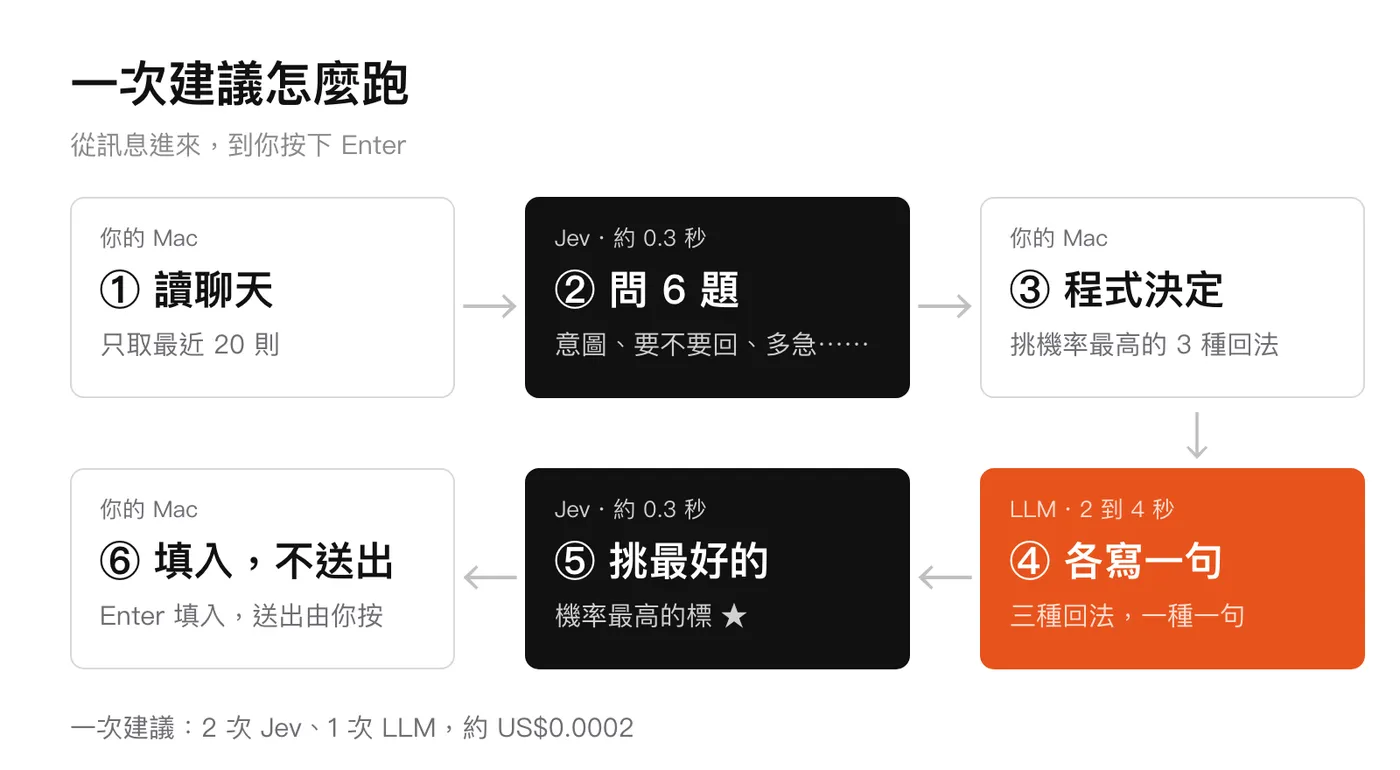
我們順著上面這張圖,看一次建議從訊息進來到你按下 Enter,中間發生了什麼事。
新訊息進來、畫面停住 1 秒之後,Wingman 開始讀聊天,只取最近 20 則,交給 Jev 一次問六題:意圖、要不要回、多急、哪幾種回法最能推進對話、氣氛多緊張、有沒有話中有話,每題都附機率。
接著由程式決定。「要不要回」低於 0.5 就停在這裡,不叫 LLM;否則取機率最高的三種回法,請 LLM 照三種回法各寫一則,寫好一則先顯示一則。三則都寫好之後,再把它們當成同一題的選項問 Jev 一次,機率最高的標上 ★。最後按 Enter 或 1 到 3,文字進輸入框,其餘就由你自己來。
這樣分工是因為價差。判斷一次大約 1,000 到 1,800 個 input token,不到 0.0001 美元,寫一則草稿則是它的 2 到 3 倍。先讓便宜的 Jev 決定值不值得寫,閒聊跟公告底下就不會白叫一次 LLM,輸入框上方也不會多浮一顆打擾人的提示。
Jev 問的六題#
先看一個實際的例子。下面這張圖是 Jev 判斷一則訊息的樣子:對方問「今天下班前能不能發版?」,它回答對方想催進度、需要回、最適合的回法是給進度和時間,每個答案都附一個機率。LLM 寫好三則草稿之後,Jev 會再被叫一次,把三則草稿當成同一題的三個選項來排名。對方只說了一句「感恩 :)」的時候,三則草稿拿到 99%、0%、1%,它挑中「不客氣,有需要再跟我說!」,換我也會選這則。
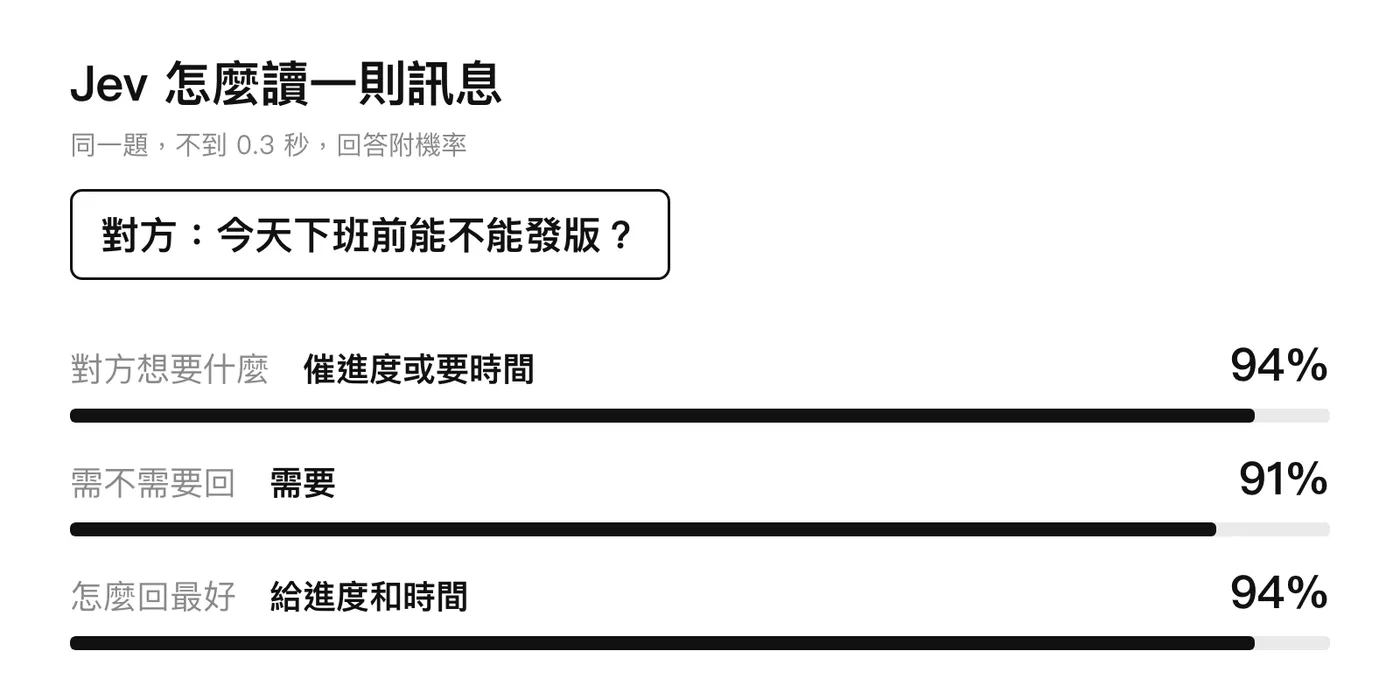
每次建議實際問的是下面六題。選項是我自己列的,Jev 只負責從裡面挑,並告訴我們它有多確定:
- 對方想要什麼 → 問資訊、請求或交辦、催進度、確認或同意、告知、閒聊、抱怨、感謝,共八種
- 需要回嗎 → 是或否,附機率
- 多急 → 0 到 3 分,從「幾天內」到「馬上」
- 怎麼回最能推進對話 → 直接答應、答應但附條件、給進度和時間、先問清楚、婉拒或延後、表達感謝、簡短回應,共七種
- 氣氛多緊張 → 平和、留意、緊張、快吵架、翻臉,共五級
- 有沒有話中有話 → 是或否,附機率
後面兩題是這個專案後來加的。氣氛偏緊張的時候,三則草稿會先把事情講開,不急著附和。另外,如果機率最高的三種回法全都是「答應」,第三則會換成「婉拒或延後」,因為三則都答應的話,做不到的人就沒有一則可以選了。
整體架構#
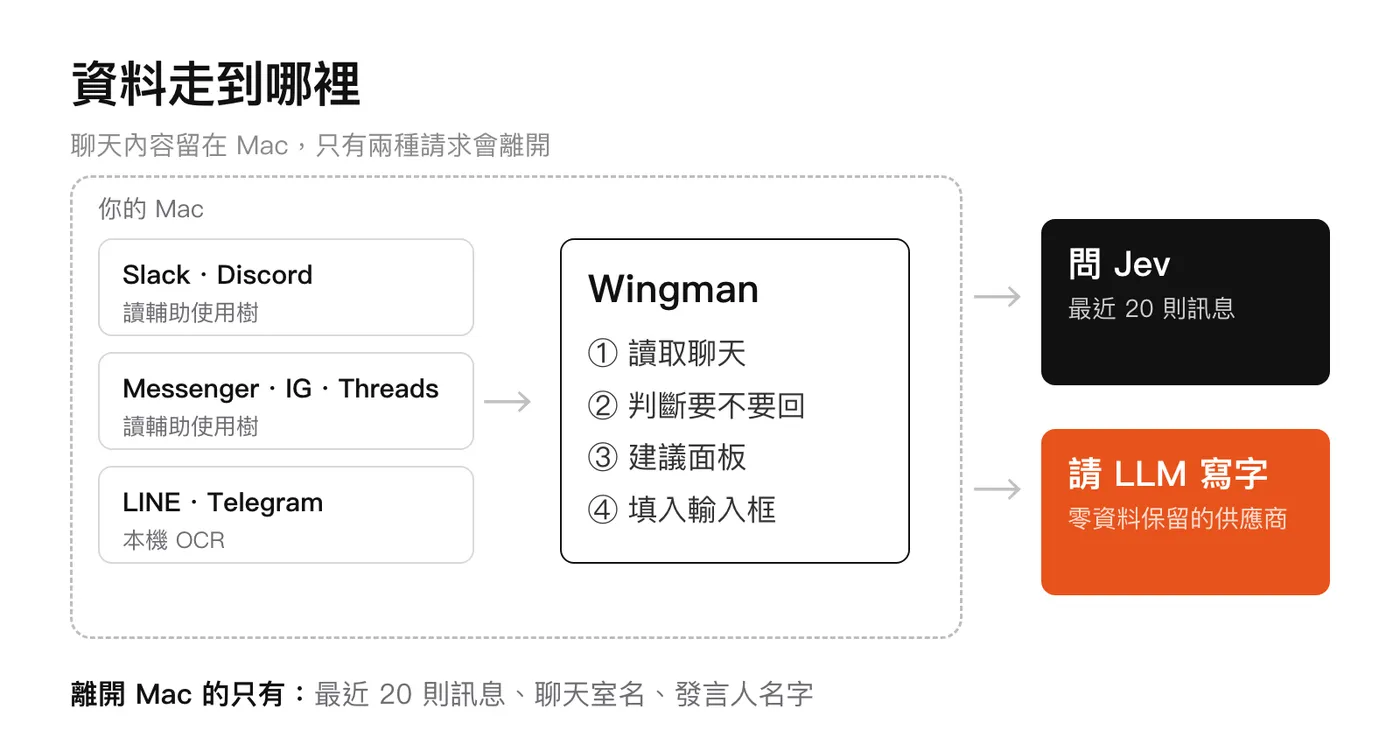
圖中虛線框是你的 Mac,裡面有聊天 App 和 Wingman 本身,框外是 Mac 之外。只有兩種請求會離開你的電腦,一種是問 Jev,一種是請 LLM 寫字。讀訊息、判斷要不要繼續、顯示面板、把文字填進輸入框,全部都在你的 Mac 上完成。
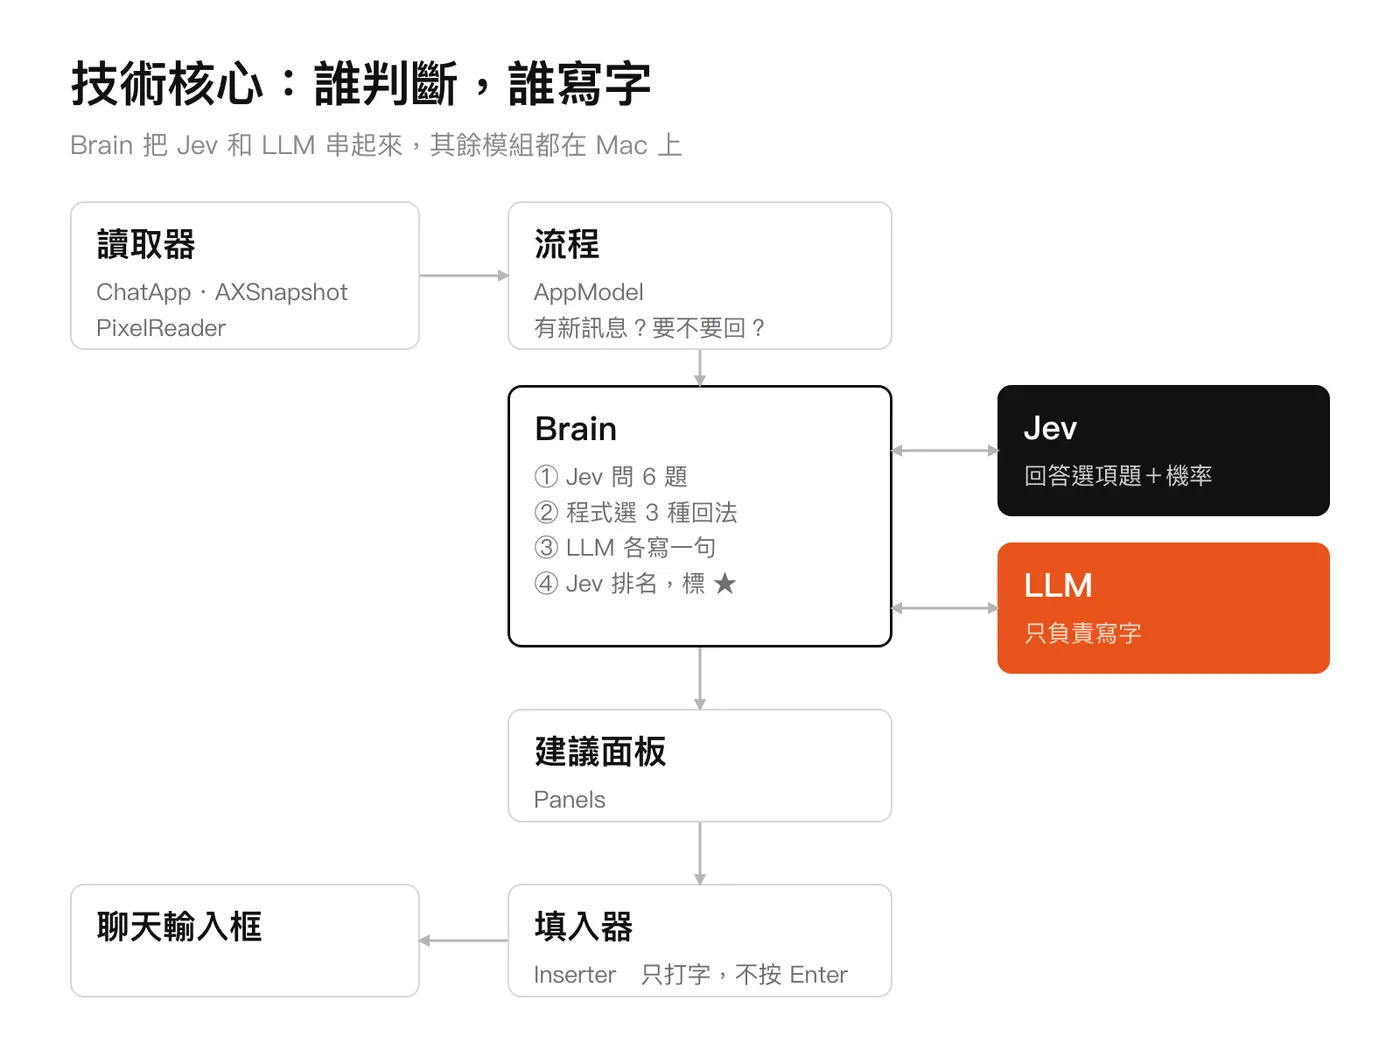
再往裡面看一層,就是程式的核心。Brain 是唯一同時跟 Jev 和 LLM 講話的模組:先問 Jev 六題,程式根據答案挑出三種回法,LLM 照著各寫一句,最後再讓 Jev 替三句排名、標上 ★。讀取器、流程、面板、填入器都只做自己那件事,不碰模型。
每個聊天 App 怎麼讀#
做這個專案的第一步,是用 macOS 的 Accessibility API 把每個 App 都探一遍,因為它們的差別非常大。
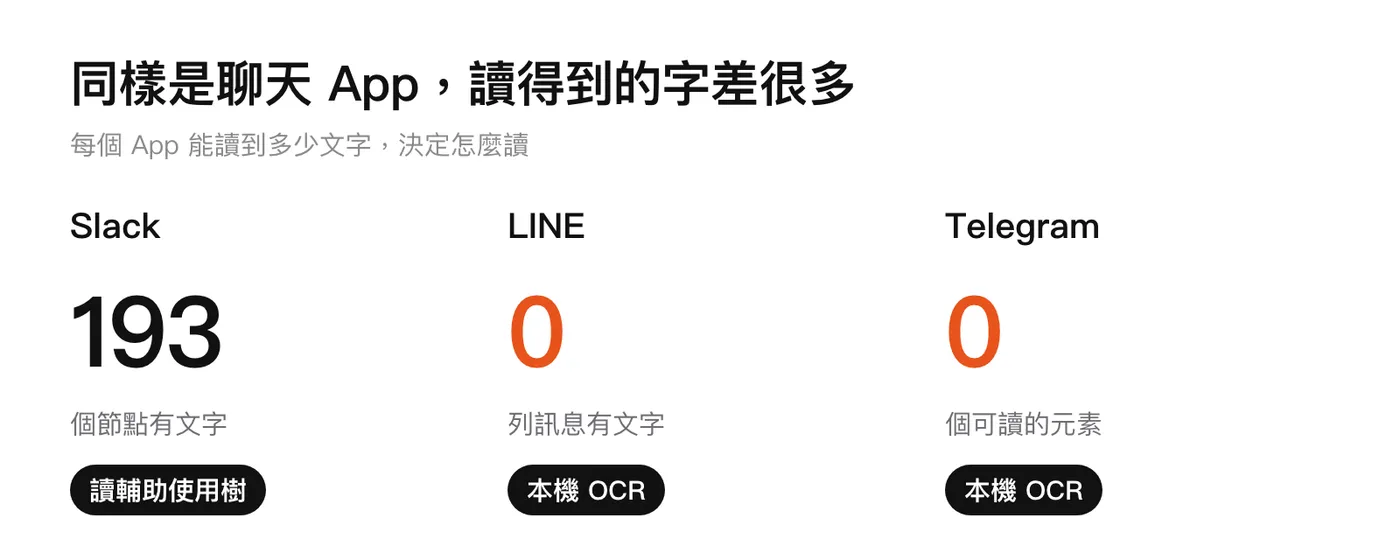
探出來的結果在上面這張圖。Slack 和 Discord 都是 Electron 做的,輔助使用樹整棵 DOM 都讀得到,只需要「輔助使用」權限。Messenger、Instagram、Threads 的網頁版也是讀輔助使用樹,而且只在確切的網址上讀。
LINE 就不一樣了,聊天室名稱和輸入框還讀得到,訊息本身卻是空的。Telegram 更徹底,輔助使用樹整個是空的。這兩個 App 拿不到訊息文字,所以要再加上「螢幕錄影」權限,改用 Apple Vision 在本機做 OCR,截圖不會上傳。中文辨識相當準,誰說的話則用泡泡的 x 座標來分:對方的從左邊約 12% 開始,自己的在約 93% 結束。
Slack、Discord、Messenger、Instagram、Threads 我已經在真實聊天上用過,LINE 和 Telegram 因為走 OCR,目前用得比較少。
網頁版還有一個額外的限制:瀏覽器裡只讀這三個網站的訊息頁。Instagram 和 Threads 貼文底下的留言,只會讀游標所在輸入框的那一則貼文,單純滑動動態牆不會讀任何東西。回在貼文底下的是公開留言,面板上也會特別標明。
寫草稿的模型:最便宜的不一定划算#
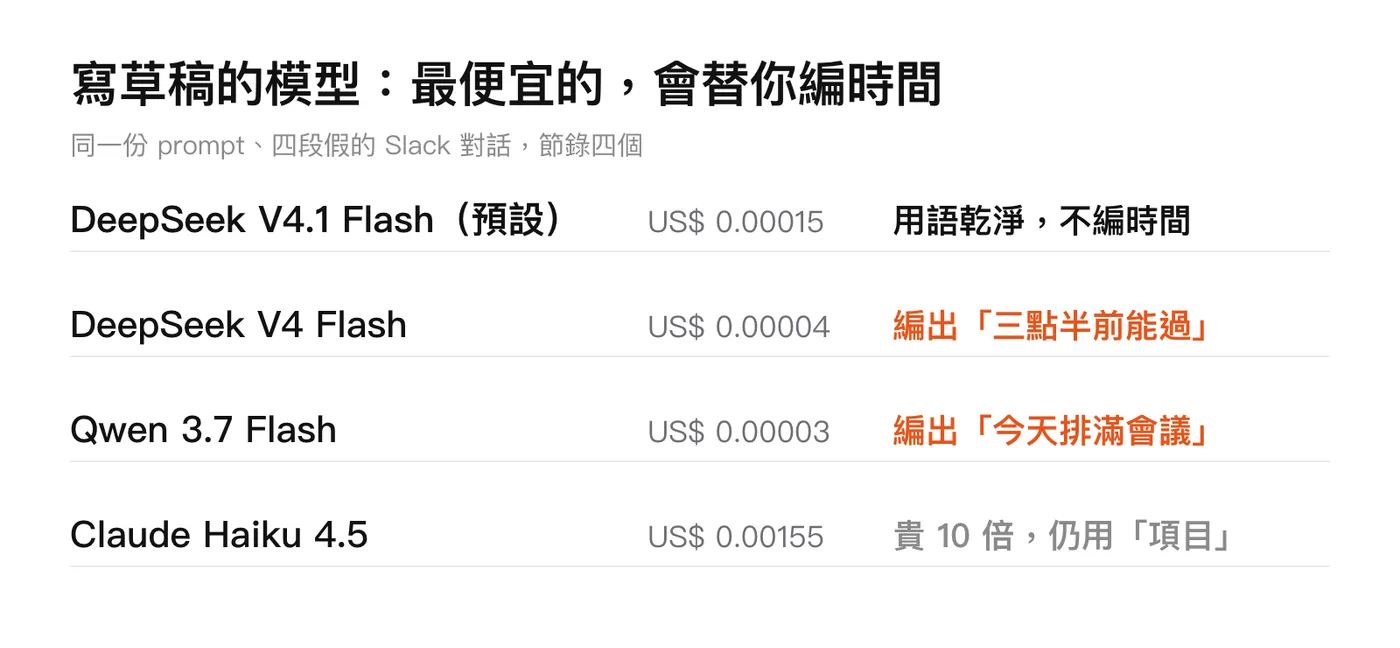
寫草稿的模型,我用 scripts/bench-writers.py 拿四段假的 Slack 對話、同一份 prompt 逐一測試,再用 OpenCC 數有幾處不是台灣用語。以下是 9/27 在台灣量到的結果,圖中節錄四個,六個的完整結果在圖下面的文字版:
文字版的結果如下:
- DeepSeek V4.1 Flash → 平均 1.7 秒、每次 0.00015 美元,台灣用語最乾淨(0 處),不知道的時間會留
[時間] - DeepSeek V4 Flash → 3.5 秒、0.00004 美元,編出時間:「三點半前能過」「明天早上給你修正版」
- Qwen 3.7 Flash → 2.4 秒、0.00003 美元,編出行程:「下午兩點後」「今天排滿會議」
- 另外三個(Qwen 3.8 Flash、Gemini 3.1 Flash-Lite、Claude Haiku 4.5)每次 0.0001 到 0.00155 美元,沒有編造內容,只是混進了「还」「數據」「項目」這類不是台灣用語的字
最出乎我意料的是,最便宜的那兩個模型,會替我寫出對話裡一個字都沒提過的時間和行程。這種草稿讀起來最順,一不注意就按下 Enter,等於替我答應了一件事。DeepSeek V4.1 Flash 雖然貴了好幾倍,一次也才 0.00015 美元,換來的是我不用逐字檢查它有沒有亂承諾,所以我選它當預設。
另外有兩個地方也跟大家分享:
- OpenCC 的數字只能拿來篩掉明顯不行的模型,它連「權限」都會改成「許可權」,所以草稿還是得一則一則讀
- 回覆的語言由程式先判斷再告訴寫手,因為只在規則裡寫「用對方的語言回」,對方用英文道謝時,多數模型還是回中文
公司的對話會經過誰的主機#
Slack 裡的對話是公司資料,所以資料的去向,我在跑 bench 之前就先決定好了:
- 沒有 Wingman 的伺服器,每個人用自己的 API key,我不會收到 key,也不會收到任何對話
- 只送最近 20 則,加上聊天室名稱、發言人名字和你的顯示名稱,判斷送給 TypeSafe,寫字走 OpenRouter
- 只走零資料保留、不蒐集資料的供應商,並且排除 DeepSeek、StreamLake、Alibaba、SiliconFlow、Baidu 這幾家中國的主機,排除之後 DeepSeek V4.1 Flash 的 1.7 秒變成通常 2 到 4 秒,偶爾 8 到 10 秒
- 聊天內容預設不存檔,想讓它記得更久可以打開「記住聊天」,每個聊天室最近 300 則會加密保存,金鑰只存在這台 Mac 的鑰匙圈,放著不開 90 天就刪
- 日誌只記時間、次數和費用,不記訊息文字,設定裡還有一顆按鈕可以全部清掉
費用方面,一次完整的建議大約 0.0002 美元,一天 20 次,一個月約 0.1 美元。這些都是按量計費的 API key,ChatGPT 和 Claude 的訂閱沒辦法給第三方 App 使用。
我也試過 macOS 26 的 Apple 端側模型(FoundationModels)。它支援 zh-Hant-TW、免費、資料不出電腦,拿來處理公司對話最讓人放心。不過第一則回覆就等了 18.6 秒,對話問的是今天,它卻寫「明天上午發版」,連誰該回客戶都搞錯,所以沒有當預設。
為什麼只填、不送#
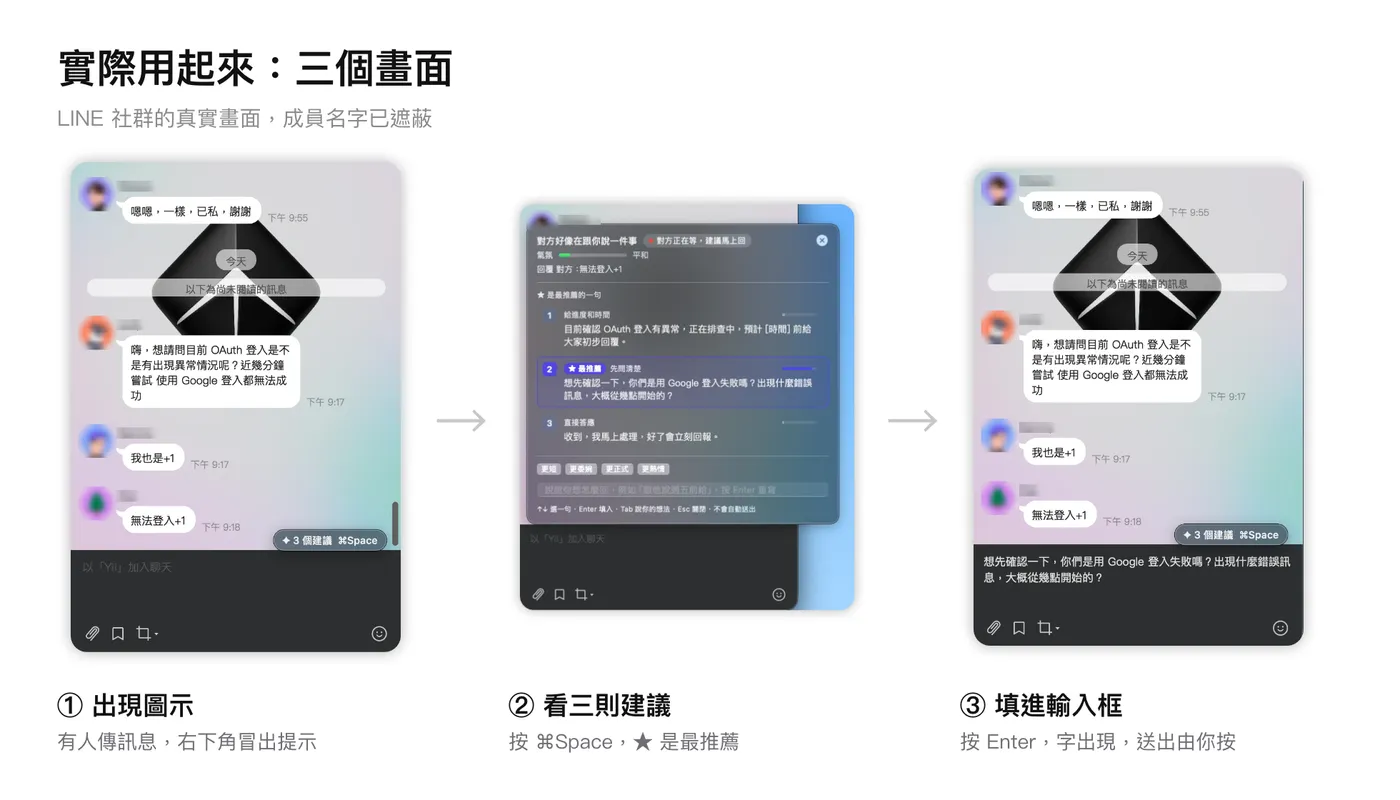
Wingman 對其他 App 唯一做的事,就是把你選的草稿打進輸入框。下面是 LINE 社群裡的真實畫面(成員名字已經遮蔽):右下角冒出提示、按 ⌘Space 看三則建議、選一則之後字出現在輸入框,送出的那下還是你按。注意第一則建議寫的是「預計 [時間] 前」,它不知道時間,就留空格給我填。
它還有幾道保護:
- 它不按 Enter,連草稿裡可能被當成 Enter 的字元都會先拿掉,因為在 Slack 裡換行就等於送出
- 打字之前會先確認聊天室還是原本那個、輸入框有焦點,只要有一項不符,就改成把草稿放進剪貼簿
- 別人傳來的訊息會以純文字交給模型,惡意的訊息可以試著帶偏草稿,所以送出前一定要讀過一遍,不過模型沒有任何工具和金鑰,也碰不到其他聊天室
面板上我也刻意不顯示百分比。Jev 的機率很容易衝到兩端,一則合理的草稿旁邊寫著 0%,第一眼會讀成「這則寫錯了」,所以我改用「★ 最推薦」跟「也不錯」兩種標籤,數字收進 tooltip。
自己裝來用#
需求是 macOS 14 以上、Xcode 16 以上,以及 brew install opencc,接著執行:
git clone https://github.com/chyiiiiiiiiiiii/jev-wingman.git
cd jev-wingman
./scripts/install.sh
第一次開啟會帶我們走三步:授權、填 key、設定顯示名稱。key 的部分,OpenRouter 一定要填,TypeSafe 選填,有填的話判斷會快上好幾秒。
總結#
這篇文章分享了 Wingman 的做法:讓 Jev 判斷要不要回、怎麼回,讓 LLM 負責寫,再讓 Jev 幫草稿排名。如果大家也想做類似的工具,我自己的經驗有三點。
- 先探每個 App 的輔助使用樹再決定架構,因為 Slack 和 LINE 看起來差不多,讀法卻完全不同
- 挑寫手模型要用自己的對話一則一則讀,重點看它會不會替你答應事情
- Enter 一定要留給使用者自己按
接下來我想繼續優化 LINE 和 Telegram 的 OCR,也想用日誌看看 ★ 那一則實際被選中的比例有多高。有興趣的朋友歡迎留言跟我分享你的想法。
延伸閱讀#
- 你的 widget tree 已經是一份選項清單:「讓 Jev 挑,讓 LLM 寫」這個分工最早是在這篇
參考與相關資源#
- Introducing System One models and Jev
- jev-chat-jarvis:Wingman 的骨架參考了它,一個 App 配一個 reader、讀得到文字就不截圖、只填不送
- jev-wingman